Branże
Dane i AI dla telekomunikacji
Telekomunikacja żyje na ogromnych wolumenach danych sieciowych, które często nie mogą opuścić data center. Budujemy platformy, które przetwarzają je szybciej i taniej, i AI, które na nich działa.
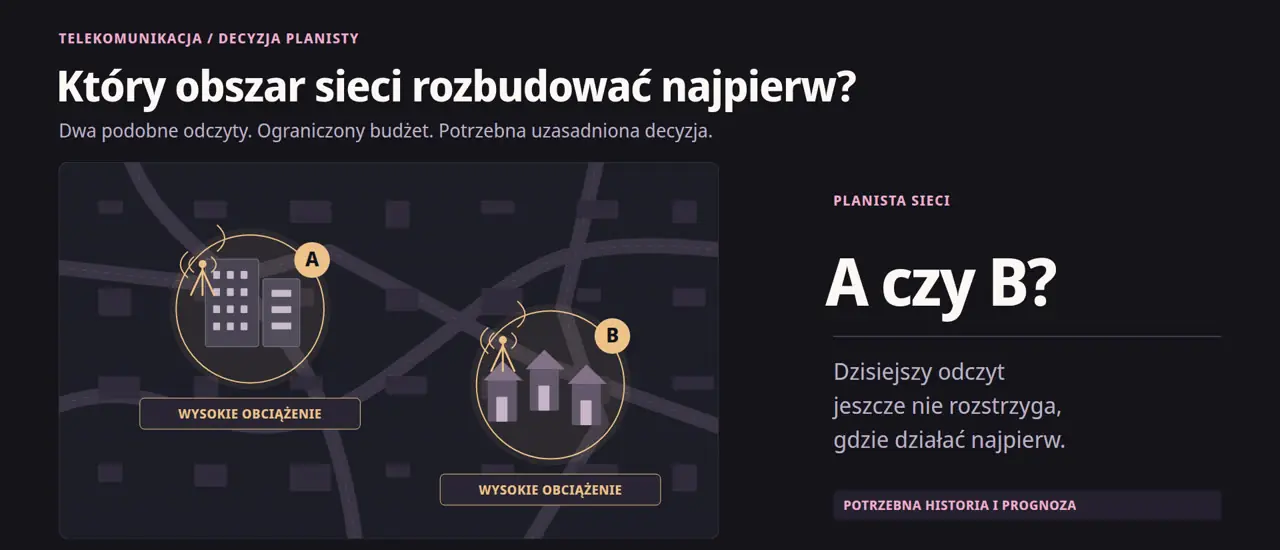
Który obszar sieci rozbudować najpierw?
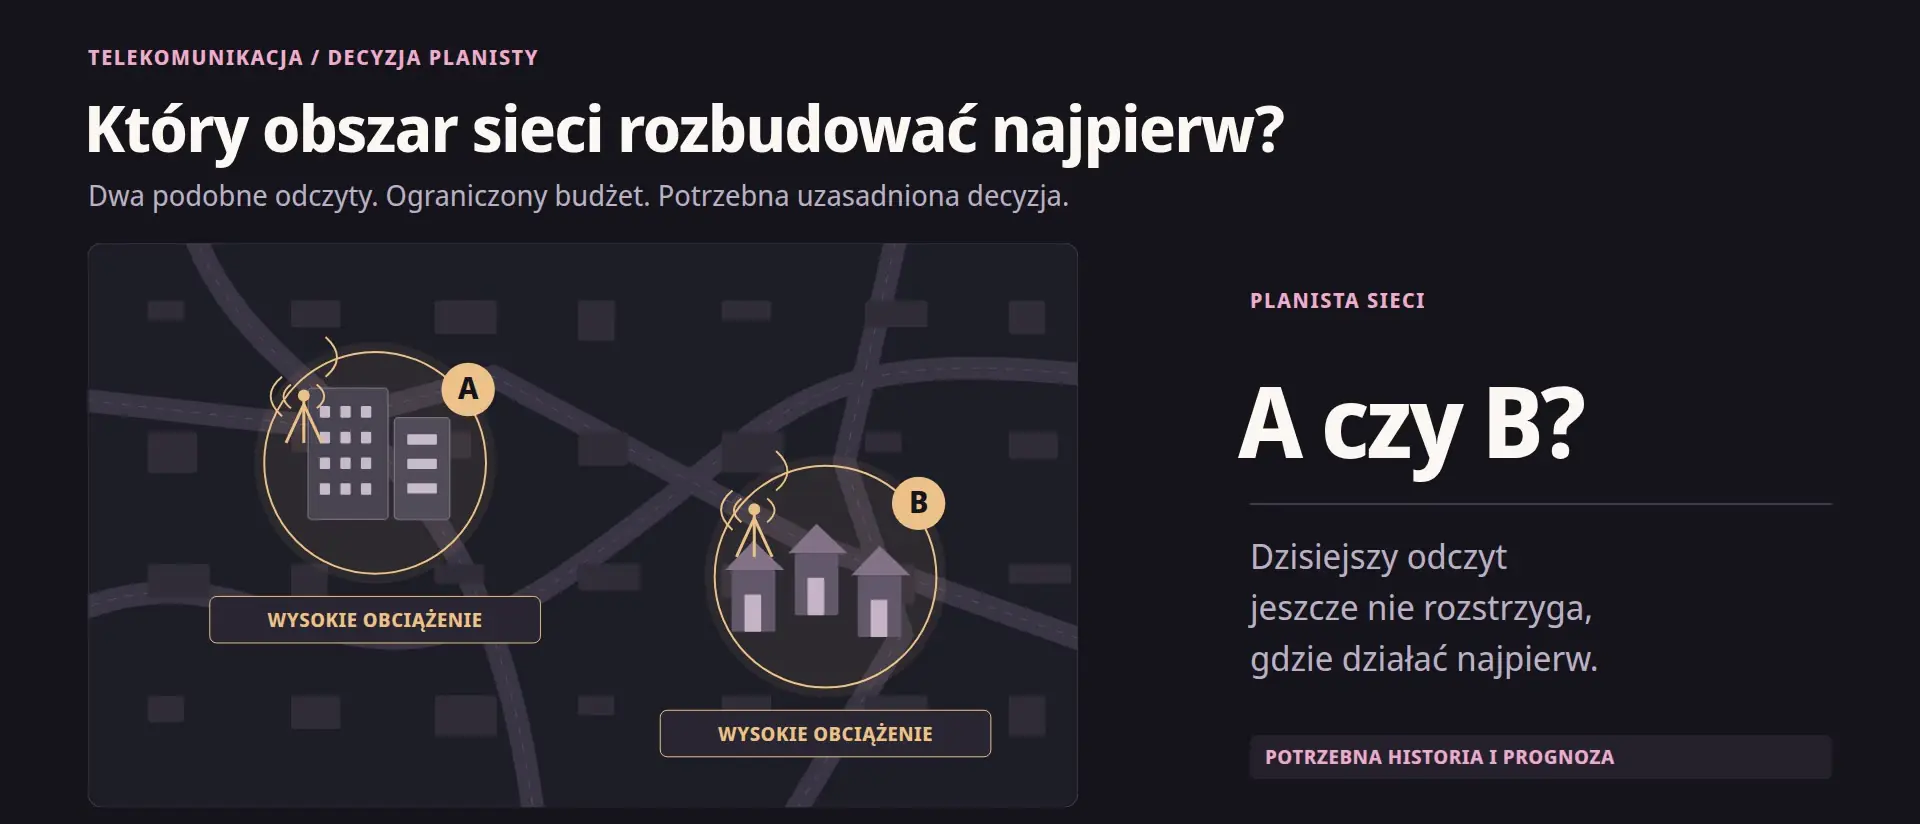
Dwa obszary są mocno obciążone, a budżet rozbudowy ograniczony. Dzisiejszy odczyt tego nie rozstrzyga: w jednym obszarze szczyt wraca codziennie o tej samej porze, w drugim ruch stale rośnie.
01 / 06
Który obszar rozbudować?
Wyobraźmy sobie planistę sieci telekomunikacyjnej. Dwa obszary są mocno obciążone, a budżet rozbudowy jest ograniczony. Który powinien dostać pierwszeństwo? Dzisiejszy odczyt jeszcze tego nie rozstrzyga.
02 / 06
Co zmienia historia i prognoza?
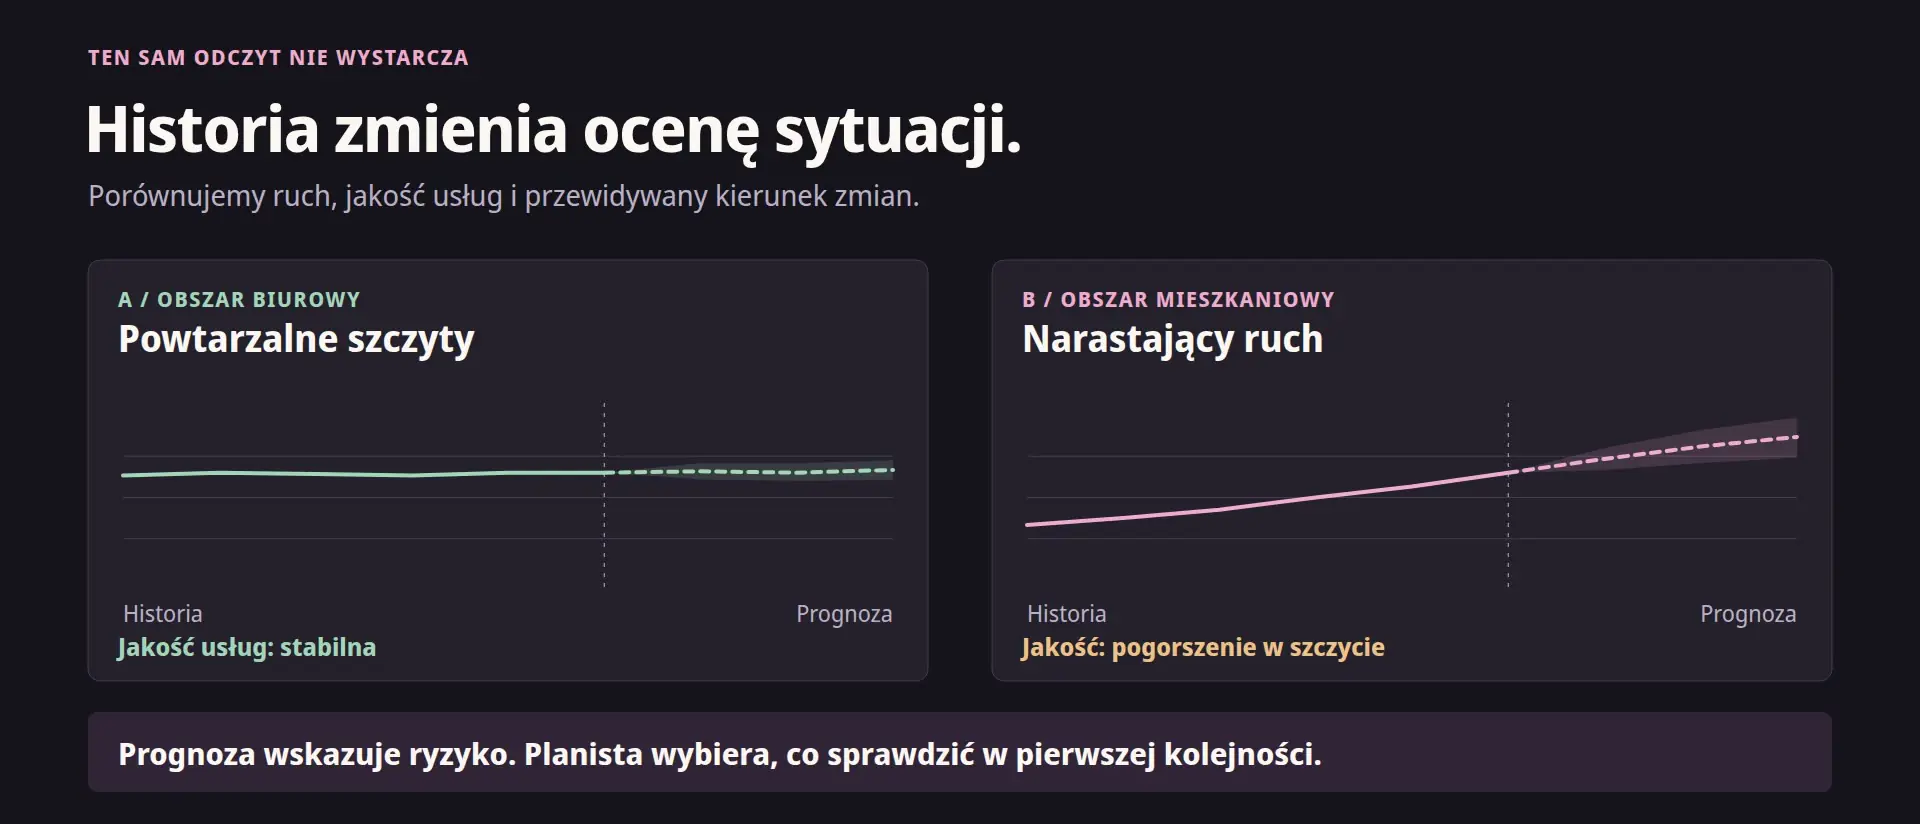
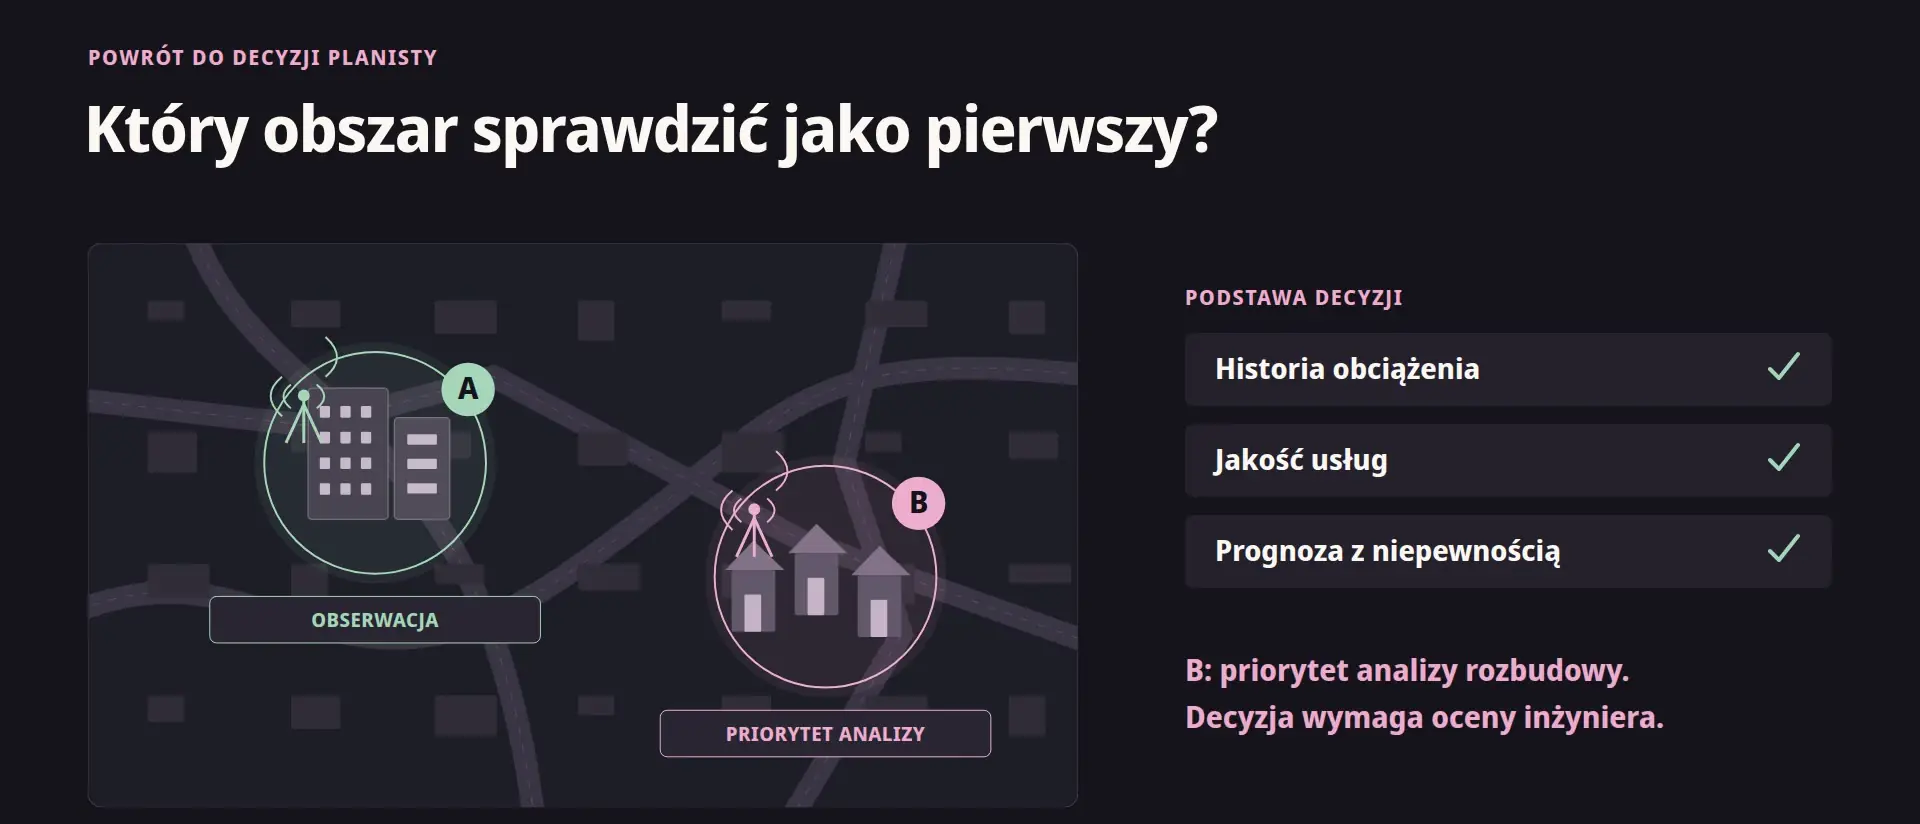
W obszarze biurowym wysokie obciążenie regularnie wraca o tej samej porze, a jakość pozostaje stabilna. W obszarze mieszkaniowym ruch rośnie, a w godzinach szczytu pojawiają się problemy. Planista potrzebuje historii, informacji o jakości i prognozy. Na tej podstawie wybiera, gdzie najpierw zbadać potrzebę rozbudowy.
03 / 06
Po co temu platforma danych?
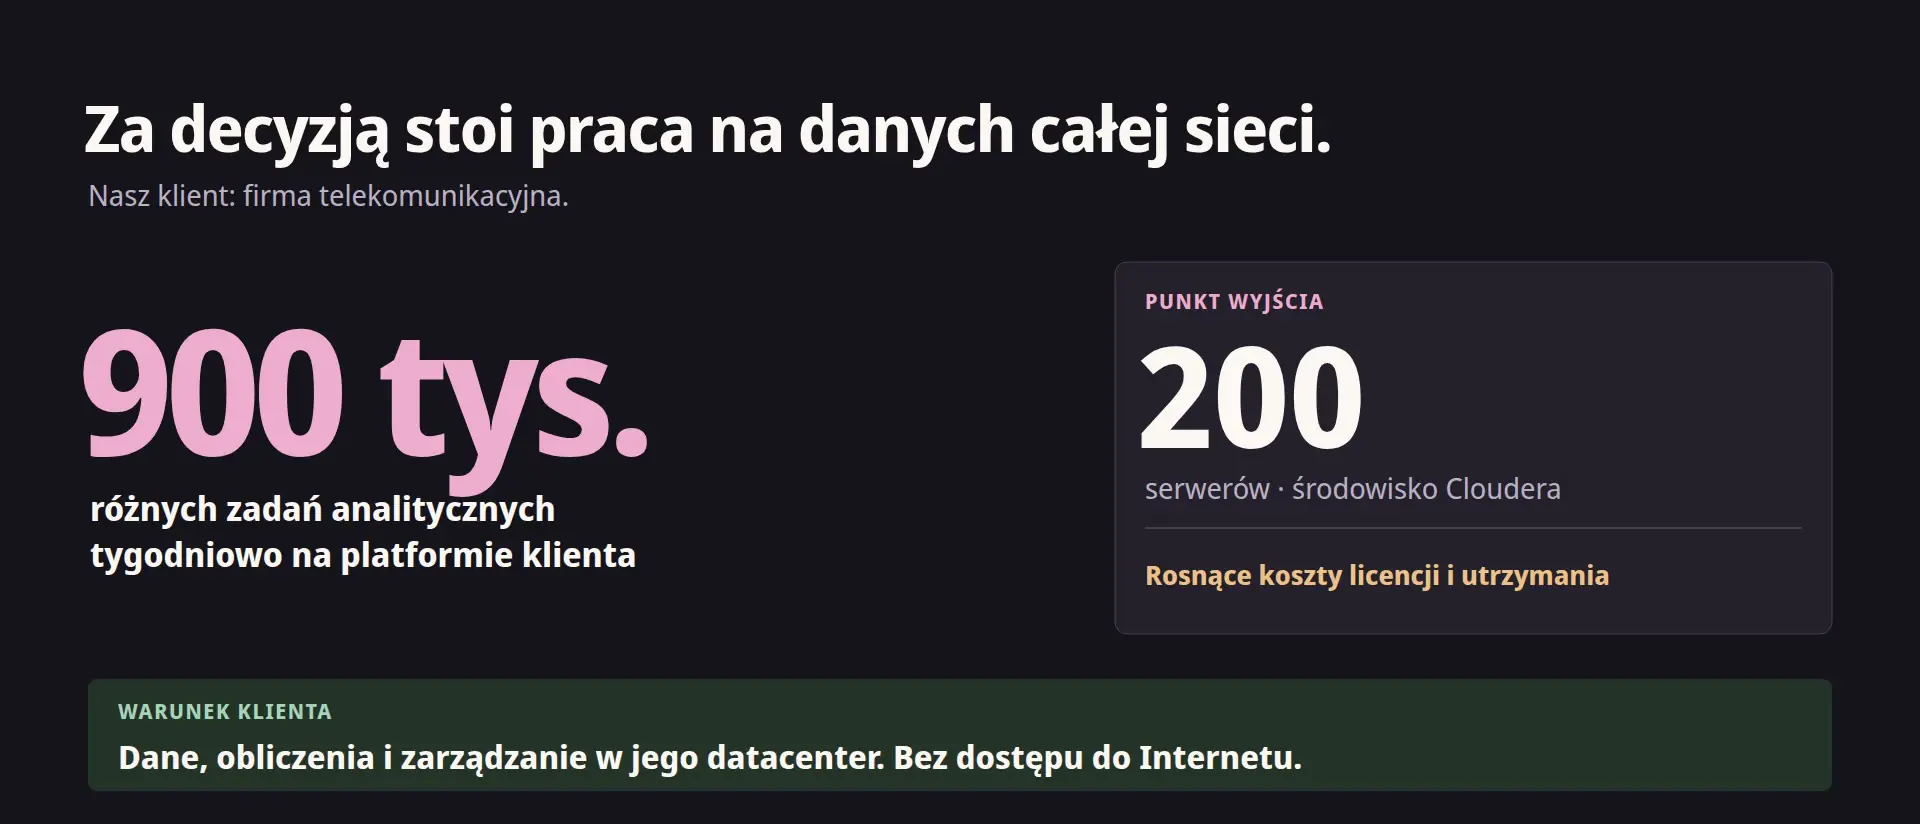
Takie decyzje wymagają przeliczania danych z całej sieci. Naszym klientem była firma telekomunikacyjna. Jej platforma wykonywała dziewięćset tysięcy różnych zadań tygodniowo. Rosły koszty, a zespoły potrzebowały sprawniejszych analiz i modeli. Wszystko musiało działać w data center klienta bez Internetu.
04 / 06
Co zrobił Sofixit?
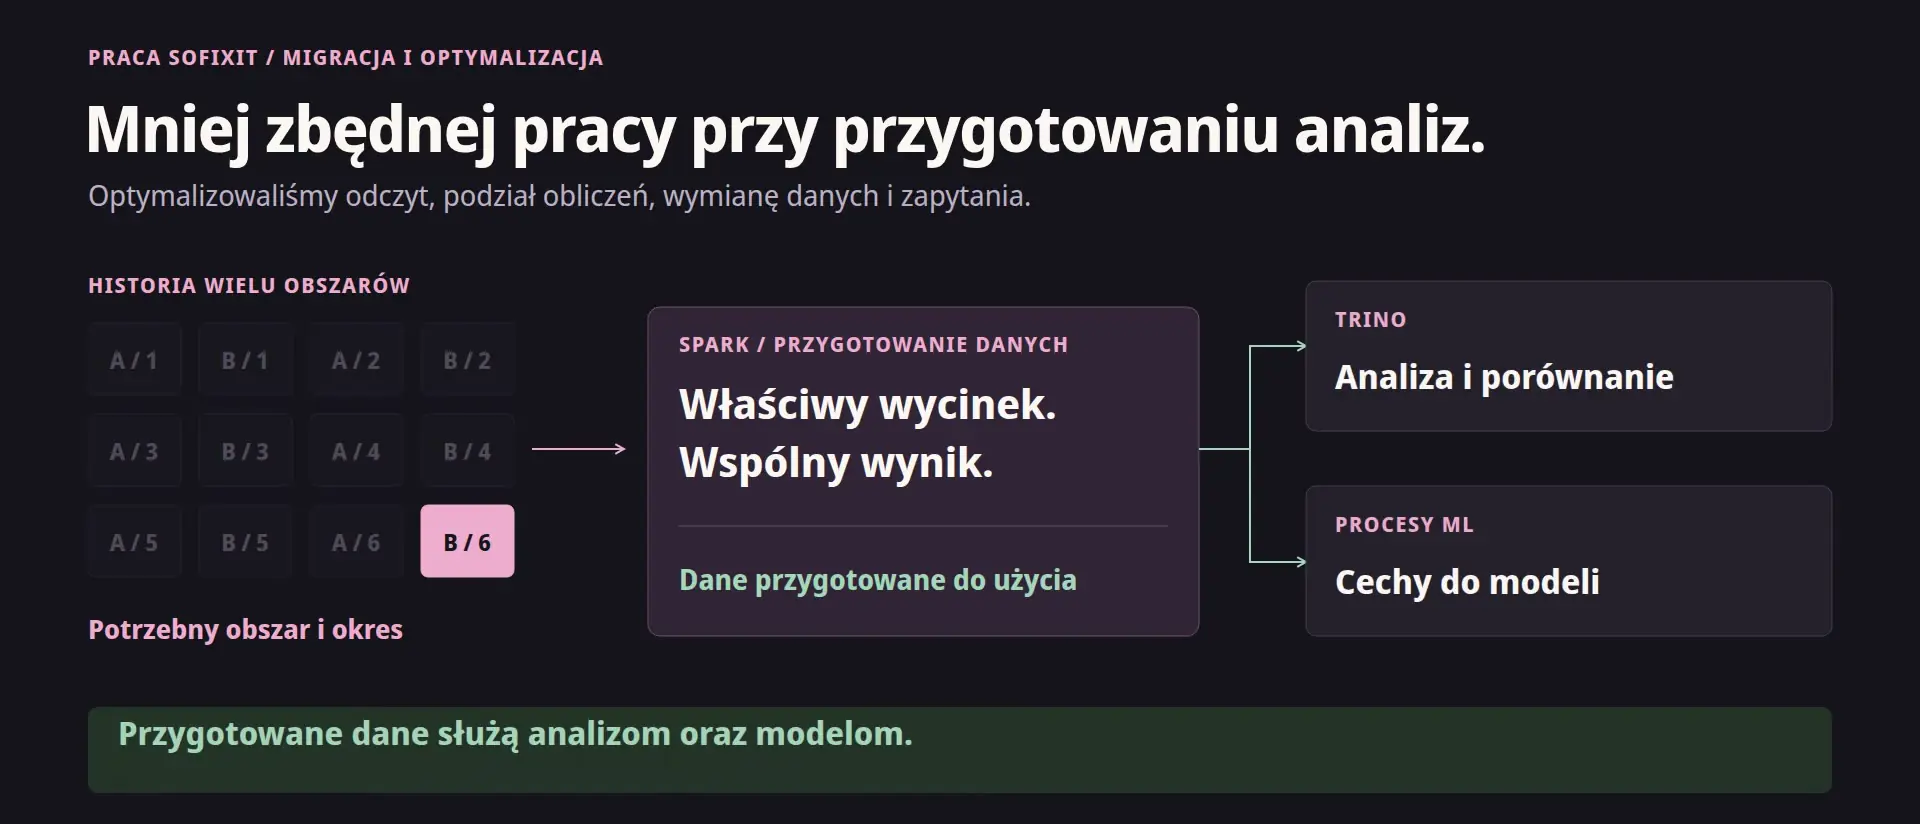
Sofixit przebudował platformę i zoptymalizował sposób wykonywania tej pracy. Poprawiliśmy odczyt danych, podział obliczeń, wymianę danych między procesami oraz zapytania. Spark przygotowywał dane, a Trino udostępniało zapisane wyniki do analiz. Procesy ML korzystały z tego samego fundamentu.
05 / 06
Powrót do decyzji planisty
Widzi, na czym oparto wskazanie i może porównać warianty działania. Takiemu wykorzystaniu danych służy nowoczesna platforma.
06 / 06
Wynik modernizacji platformy
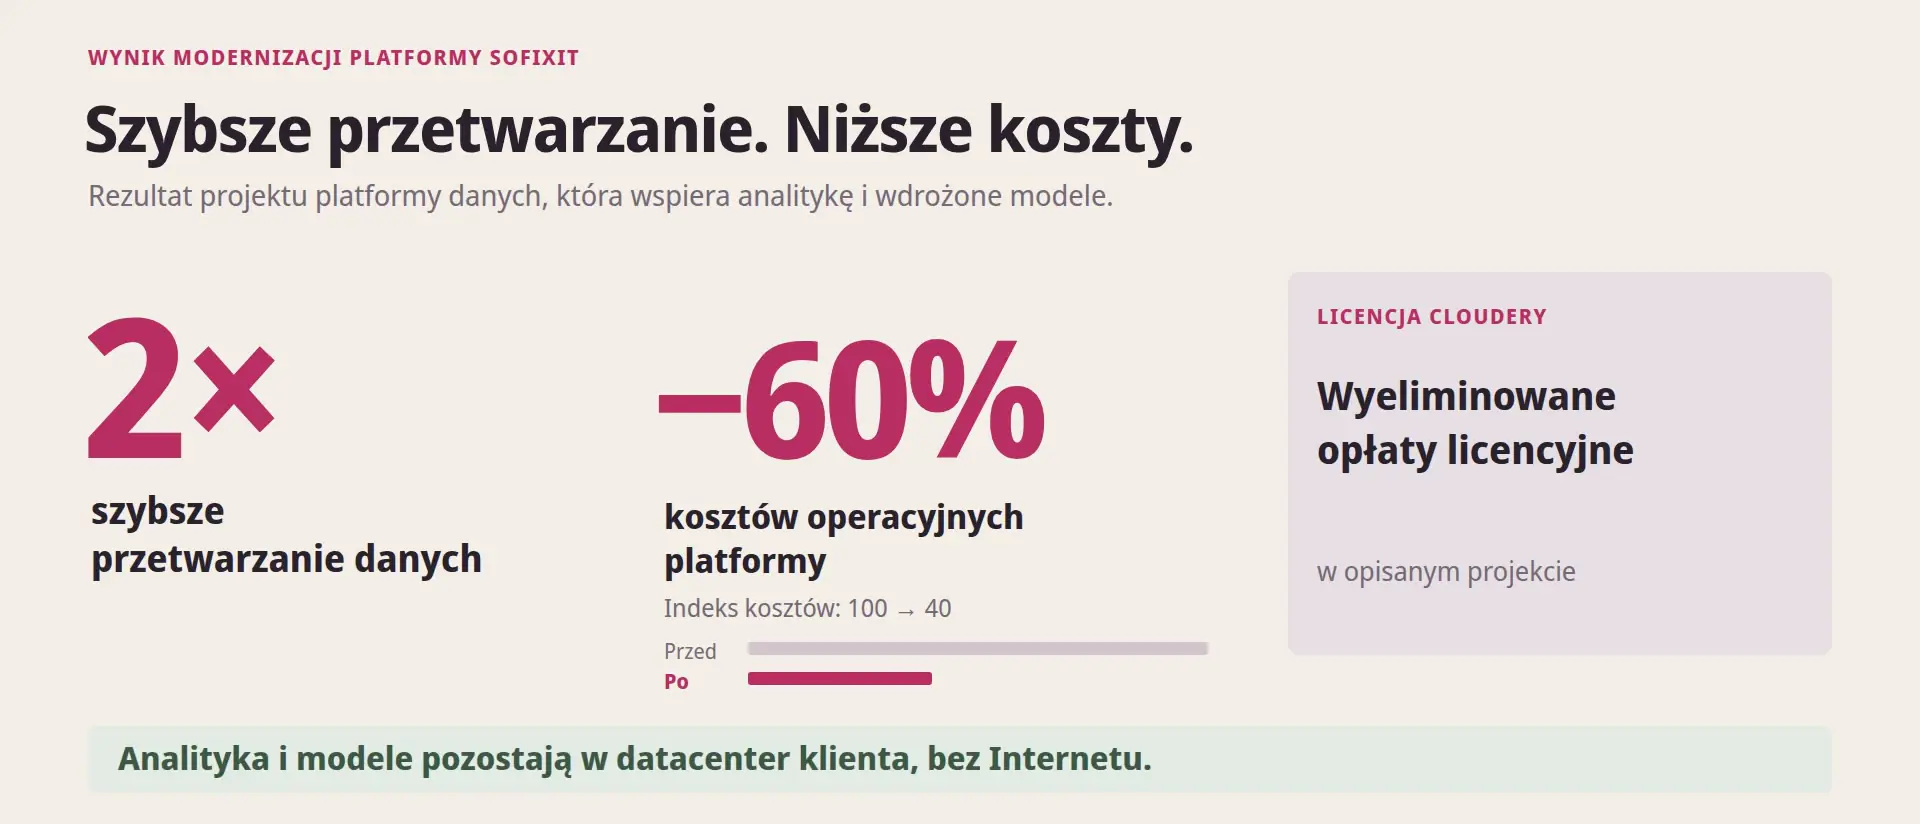
W opisanym projekcie przetwarzanie przyspieszyło dwukrotnie, a koszty operacyjne spadły o sześćdziesiąt procent. Wyeliminowano opłaty za licencję Cloudery. Analityka i wdrożone modele pozostały w data center klienta.
Problemy, które rozwiązujemy dla operatorów
2×
Drogie i wolne platformy danych
Przejście etapami z Cloudera na Spark i Trino: dwa razy szybciej, 60% niższe koszty operacyjne, bez opłat licencyjnych.
<1 s
Dane z sieci, które przychodzą za późno
Przetwarzanie strumieniowe na Kafka i Flink: opóźnienie z 5 minut do poniżej sekundy, 25% lepsza dostępność sieci.
03
Godziny SQL na jedną odpowiedź
Asystent AI nad warstwą semantyczną metryk sieci: wykres zamiast ok. 4 godzin ręcznego zestawiania danych.
04
Wiele alertów, jeden incydent
Agent łączy zdarzenia, proponuje poprawkę w sieci i czeka na akceptację inżyniera, zanim cokolwiek się zmieni.
Na początek
Pytania, które zadają kupujący
Czy możecie pracować w środowisku odciętym od internetu?
Tak. W projekcie platformy danych dla operatora wszystko działało w data center klienta bez dostępu do internetu.
Czy agent AI sam zmieni coś w naszej sieci?
Nie. Proponuje polecenie, pokazuje skutki i czeka na akceptację; działania o niskiej pewności przechodzą dodatkową walidację.
Jak migrujecie, nie psując istniejących raportów?
Etapami, porównując wyniki zadanie po zadaniu przed każdym przełączeniem, z planem powrotu na każdym kroku.
Porozmawiajmy o Waszym projekcie
Opiszcie swój przypadek
Wybierzcie jeden problem.
Pokażcie dostępne dane.
Ustalmy mierzalny cel.
Wskażcie proces i dane, które macie. Odezwie się inżynier, nie call center.
Odpowiadamy w ciągu jednego dnia roboczego.