Książka · wydawca Sofixit
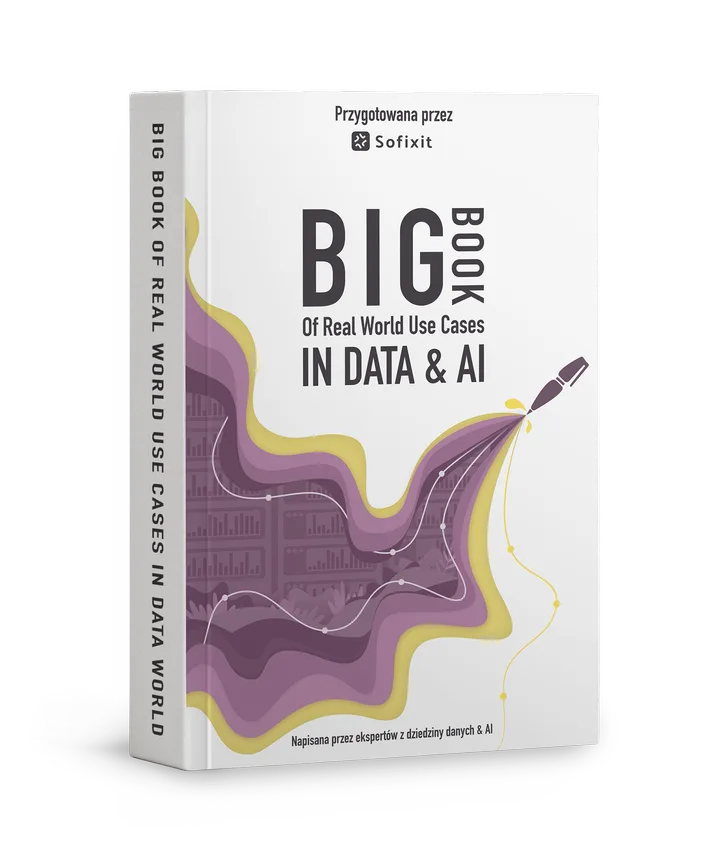
Big Book of Real-World Use Cases in Data & AI
Ponad 400 stron o błędach, kompromisach i architekturze z prawdziwych wdrożeń, napisanych przez 31 praktyków. Bez teorii i bez marketingowego lukru. Pierwszy nakład rozszedł się w całości - zostawcie adres, a damy znać o dodruku i wersji e-book.
autorów i rozdziałów
stron
części: opowieści, case studies, wywiady
premiera 18 marca, po polsku
Dla kogo
Dla osób, które już coś wdrażały i chcą porównać swoje decyzje z decyzjami innych praktyków.
Junior / Mid
Przeskoczysz trzy lata błędów w osiem wieczorów czytania.
Zobaczysz, jak wyglądają systemy produkcyjne od środka, zanim sam będziesz musiał je naprawiać.
Senior / Architekt
Zobaczysz kompromisy w systemach o dużej skali.
Porównasz swoje decyzje z decyzjami 31 liderów z branży i poznasz architektury, których nie ma w tutorialach.
Manager / CTO
Dowiesz się, jak układać zespoły Data, żeby dostarczały zwrot.
Nie tylko prowadzenie projektów, ale dostarczanie wartości. Poznasz plan „Pierwsze 100 dni Head of Data”.
To nie jest książka dla Ciebie, jeśli…
- szukasz podstaw Big Data i AI albo wprowadzenia dla początkujących. Jest napisana zawodowym, wyspecjalizowanym językiem, którym na co dzień posługują się profesjonaliści z branży.
Co jest w środku
Trzy części: od eksperckich opowieści, przez realne case studies, po dogłębne wywiady. Każdy rozdział jest samodzielną całością - czytasz w dowolnej kolejności.
01
Część I: Eksperckie opowieści
Autorskie historie o wybranych zagadnieniach w praktycznym ujęciu: realne decyzje architektoniczne, ich konsekwencje i wnioski z życia projektów data.
02
Część II: Case studies
Opisy rzeczywistych wdrożeń, m.in. BCNN (dawniej Bielik Consulting) i Cyfronet: konkretne problemy biznesowe, zastosowane rozwiązania, efekty i lekcje.
03
Część III: Wywiady z ekspertami
Rozmowy z praktykami o AI w codziennej pracy firm, platformach danych, DataOps, Data Lake kontra Lakehouse i mitach zarządzania danymi.
- 01
Rozdział 1: Pierwsze 100 dni Head of Data
Gotowy plan działania: jak poukładać zespół, technologię i relacje z biznesem, żeby dostarczać wynik.
- 02
Rozdział 7: Rozmowy pod lupą AI
100% rozmów ocenianych w kilka minut dzięki połączeniu AWS Transcribe i modeli językowych.
- 03
Rozdział 8: 69% botów w danych - jak to naprawić?
Walka o jakość danych ankietowych: wykrywanie odpowiedzi niskiej jakości i botów, spójna taksonomia kategorii, wersjonowanie modeli i promptów.
- 04
Rozdział 12: Jak obsłużyć 8 miliardów zdarzeń dziennie
Case study o skalowaniu i optymalizacji kosztów. Konkretne liczby i architektura.
- 05
Rozdział 18: Grafy wiedzy w śledztwach i medycynie
Jak z PDF-ów, tweetów, logów i obrazów powstaje spójny graf wiedzy. Narzędzie do analizy śledczej i medycznej bez chmury.
- 06
Rozdział 20: Nie każdy problem potrzebuje LLM
Dobór narzędzia do zadania: klasyfikacja, wykrywanie anomalii, wizja komputerowa, optymalizacja tras - i typowe pułapki podejścia „najpierw LLM”.
Pytania, na które odpowiada
Jak skalować bez bankructwa?
Architektura systemu obsługującego 8 miliardów zdarzeń na dobę i to, gdzie szukać oszczędności w chmurze.
Czy Twój GenAI wyjdzie poza testy?
Realne wdrożenia modeli językowych, m.in. Bielika, które wyszły poza fazę prób i zaczęły zarabiać.
Data Lake, Mesh czy Lakehouse?
Dlaczego liderzy wybierają konkretne rozwiązania i jakie kompromisy musieli zaakceptować - zamiast gonienia za hasłami.
Jak uratować jakość danych?
Dlaczego modele ML psują się po tygodniu pracy na prawdziwych danych. Case study o odsiewaniu botów w skali 12 000 sklepów.
Autorzy o książce
Krótkie nagrania autorów o tym, co wnieśli do książki i dlaczego warto po nią sięgnąć.
Tomasz Tarczyński
Head of Data Science, IPF
Krzysztof Jędrzejewski
AI R&D Director, Pearson
Marcin Grzelak
Data Analytics Manager, Travelist
Patryk Hyla
Head of IT & Data, Danone
Kinga Barczewska-Pflanz
Head of Tech & Data, In-Pulse
Michał Krzyżanowski
Head of Data & AI, KUBO
Michał Domański
Współzałożyciel, BCNN (dawniej Bielik Consulting)
Filip Dzięcioł
Senior Data Engineer, Billennium
31 ekspertów dzieli się wiedzą
Praktycy, liderzy i architekci rozwiązań data, którzy na co dzień pracują z danymi w organizacjach na całym świecie. Każdy wnosi własną perspektywę: inną ścieżkę zawodową, kulturę organizacyjną i skalę projektów.
Patryk Hyla
Head of IT & Data
Danone
Krzysztof Jędrzejewski
AI R&D Director
Pearson
Renata Bratkowska
Chief Data Officer & AI
Grupa NEUCA
Mateusz Jakitowicz
Chief Data Officer
Autopay
Kinga Barczewska-Pflanz
Head of Tech & Data
In-Pulse
Michał Szczudlak
Head of Data Analytics
G2A
Wojciech Piątkowski
Director of Data Analytics
Spyrosoft
Jakub Czerwonka
Chief of Data
Autopay
Michał Krzyżanowski
Head of Data and AI
KUBO
Marcin Grzelak
Data Analytics Manager
Travelist
Tomasz Tarczyński
Head of Data Science
International Personal Finance Plc
Paweł Gołąb
Współzałożyciel
BCNN (dawniej Bielik Consulting)
Michał Domański
Współzałożyciel
BCNN (dawniej Bielik Consulting)
Paweł Zieliński
CFO / CDO
Marek Stępień
Senior Manager
Mateusz Paździor
Head of Data Engineering
The Scalable Way
Emil Podwysocki
Deputy Head
Ośrodek Przetwarzania Informacji
Maria Bylina
Data Governance Lead
Ośrodek Przetwarzania Informacji
Kamil Raróg
CPTO
TelcoBrain
Błażej Ksycki
Head of Data
Roksana Wilk
Head of Data
ACK Cyfronet AGH
Małgorzata Belka
Senior Product Manager
Capgemini
Oliwia Walewska
AI Consultant
Rafał Wojdan
Data & AI Advisor
Onex Group
Aleksander Zawalich
Solutions Architect
Krzysztof Wasielewski
Dyrektor Operacyjny
Sofixit
Filip Dzięcioł
Senior Data Engineer
Billennium
Marta Grzybowska
Team Leader
InPost Group
Jolanta Szymaniuk
Analytics Leader
Booksy
Kacper Grzyb
Architekt danych
Sofixit
Michał Choiński
Lider IT, konsultant
Książkę tworzą specjaliści z


- …i 12 kolejnych organizacji
Recenzje
Cytujemy dosłownie, razem z zastrzeżeniami.
Marek Wilczewski
Dyrektor Zarządzający ds. Zarządzania Informacją, Danymi i Analityką, Grupa PZU
„Obawiałem się, że ponad 400 stron specjalistycznej wiedzy uwięzi mnie przy biurku na co najmniej osiem długich wieczorów. Ku mojemu zaskoczeniu, wystarczyły zaledwie dwa.”
Czytaj całą recenzję
Miała być lekturą na osiem wieczorów, a pochłonęła mnie w dwa - oto dlaczego „BIG BOOK of Real World Use Cases in Data & AI” to obowiązkowa pozycja o inżynierii danych bez marketingowego owijania w bawełnę.
Długi weekend i chwila świętego spokoju - czy można wyobrazić sobie lepsze warunki do nadrobienia branżowej literatury? Wykorzystałem ten wolny czas, aby w końcu sięgnąć po prezent, który od jakiegoś czasu czekał na mojej półce.
Obawiałem się, że ponad 400 stron specjalistycznej wiedzy uwięzi mnie przy biurku na co najmniej osiem długich wieczorów. Ku mojemu zaskoczeniu, wystarczyły zaledwie dwa. Książka jest napisana tak płynnie, że zamiast bolesnej nauki, była to po prostu czysta przyjemność z czytania. Dziś dzielę się z Wami moimi przemyśleniami.
Jako osoba, która na co dzień obserwuje projekty z obszaru danych i sztucznej inteligencji, odczuwam duży przesyt konferencyjnymi prezentacjami. Zazwyczaj wszystko działa na nich idealnie, a wdrożenia zaawansowanych modeli trwają zaledwie kilka dni. Z tego powodu do publikacji „BIG BOOK of Real World Use Cases in Data & AI” podchodziłem z dystansem. Praca zbiorowa 31 autorów niesie ze sobą ryzyko chaosu. Po lekturze muszę jednak uczciwie przyznać: to jest dokładnie ta pozycja, której polskie środowisko technologiczne potrzebowało.
Oto moje trzy główne wnioski z lektury:
1. Rzeczywiste doświadczenia zamiast haseł marketingowych
Największa zaleta tej książki kryje się w jej autentyczności. Publikacja nie powstała po to, aby promować konkretne narzędzia chmurowe czy gotowe rozwiązania technologiczne. Eksperci z firm takich jak Danone, Autopay czy Booksy otwarcie piszą o niepowodzeniach, błędach i kosztownych kompromisach inżynieryjnych. Rozdziały poświęcone architekturze systemów obsługujących miliardy zdarzeń dziennie czyta się z ogromnym zaangażowaniem.
2. Spójność perspektywy technicznej i biznesowej
Bardzo trafny okazał się podział strukturalny książki. Z jednej strony czytelnik otrzymuje rzetelne, inżynieryjne szczegóły, w tym konkretne schematy i przepływy danych. Z drugiej strony autorzy prezentują perspektywę zarządczą. Rozdział opisujący planowanie pierwszych stu dni na stanowisku dyrektora do spraw danych (Head of Data) powinien stać się lekturą obowiązkową dla każdego menedżera w sektorze IT.
3. Realia polskiego rynku technologicznego
Zagraniczne podręczniki bardzo często opisują rzeczywistość budżetową oraz kadrową gigantów z Doliny Krzemowej. Ta książka pokazuje natomiast, jak realnie wdraża się zaawansowane projekty w naszych warunkach gospodarczych - przy uwzględnieniu twardych ograniczeń finansowych oraz regulacji prawnych.
Elementy wymagające dopracowania
Przy tak dużej liczbie autorów poziom szczegółowości siłą rzeczy momentami się różni. Niektóre rozdziały są bardzo techniczne i wymagają głębokiej wiedzy z zakresu inżynierii danych, podczas gdy inne skupiają się wyłącznie na aspektach biznesowych. Warto przygotować się na to, że poszczególne fragmenty mogą wymagać odmiennego poziomu skupienia.
Ocena końcowa: 9/10
Jeśli pracujesz jako inżynier danych, architekt systemów, kierownik produktu czy lider techniczny - warto zajrzeć na stronę Sofixit Big Book i zamówić swój egzemplarz. To doskonała inwestycja w wiedzę, która prawdopodobnie uchroni Twój kolejny projekt przed popełnieniem bardzo kosztownych błędów.
Arkadiusz Dąbkowski
Enterprise Data & Data Governance Architect, The Stepstone Group
„To książka o tym, że nie jest łatwo. Opowiada, co zostaje, kiedy demo trzeba zamienić w system: procesy, dane, odpowiedzialność i pracę ludzi.”
Czytaj całą recenzję
W dyskusjach o danych i AI wciąż zbyt łatwo zachwycić się szybkim demo: promptem, prototypem, slajdem z obietnicą automatyzacji.
„Big Book Of Real Use Cases In Data & AI” idzie w przeciwną stronę. To książka o tym, że nie jest łatwo. Opowiada, co zostaje, kiedy demo trzeba zamienić w system: procesy, dane, odpowiedzialność i pracę ludzi.
Największą wartością tej publikacji jest praktyczna wiedza. Nie czyta się jej jak podręcznika, lecz jak poradnik i raport z placu budowy napisany przez praktyków dla praktyków. To wiedza z polskiego rynku, od specjalistów z firm, które działają u nas i dla nas.
Dla mnie ważne jest też to, że wiele tekstów przygotowały Koleżanki i Koledzy z DAMA Poland Chapter, czyli osoby, które gwarantują jakość przekazywanej wiedzy.
Autorzy pokazują, że o sukcesie projektów data i AI nie decydują narzędzia. Kluczowa jest jakość danych, proste procesy, sensowny ład danych i zdolność organizacji do uporania się z długiem technologicznym. Także w epoce AI najważniejsi są ludzie.
Wyraźnie wybrzmiewa tu, że AI bez fundamentów, ładu danych i właściwych ludzi przypomina samochód wyścigowy, do którego wlano paliwo złej jakości i który jedzie bez kierowcy.
Książka jest najmocniejsza tam, gdzie schodzi z ogólnych haseł do konkretnych wdrożeń. TelcoBrain pokazuje, jak wygląda AI w środowisku, które przetwarza miliardy zdarzeń dziennie i nie może pozwolić sobie na przypadkowość. Projekt analizy niedożywienia dzieci w Afryce przypomina, że prawdziwe systemy muszą działać nie w idealnym laboratorium, ale w trudnym świetle, offline, na ograniczonym sprzęcie i z odpowiedzialnością za prywatność danych. Z kolei przypadek Danone pokazuje ludzką stronę transformacji: przejście od wiedzy ukrytej w głowach kilku osób do standardów, które może utrzymać cała organizacja.
Doceniam też uczciwość tej książki. Nie sprzedaje mitu, że wystarczy kupić platformę albo wdrożyć modne narzędzie, by mieć świetne rozwiązanie i uporządkowane dane. Wręcz przeciwnie: pokazuje, że problemy trzeba naprawiać u źródła, a ład danych nie jest dokumentacją dla dokumentacji, tylko narzędziem wspierającym decyzje biznesowe.
To nie jest jednak lektura dla każdego. Osoby szukające podstaw ładu danych, AI, analityki czy chmury mogą poczuć wysoki próg wejścia. Część opisów dotyczy wielkich firm, więc nie wszystko da się przełożyć na mniejszą organizację. Forma antologii ma też swoją cenę: rytm tekstów bywa nierówny, a niektóre idee wracają.
Mimo tego „Big Book Of Real Use Cases In Data & AI” uważam za bardzo wartościową pozycję dla osób, które wyszły poza etap zachwytu nad prototypami i chcą rozumieć, jak dowozi się wartość na produkcji.
To książka dla inżynierów, liderów danych, product ownerów, ale też biznesu, który potrzebuje wspólnego języka do rozmowy o danych i AI.
Weronika Dardzińska, PhD DVM
Real World Evidence Manager & Medical Affairs, AstraZeneca
„Napisana jest przez praktyków dla praktyków - osób, które pracują z danymi, budują rozwiązania Data & AI, mierzą się z ograniczeniami projektowymi.”
Czytaj całą recenzję
„Big Book of Real-World Use Cases in Data & AI” to książka, która wyróżnia się przede wszystkim praktycznym charakterem i szerokim spojrzeniem na świat danych oraz sztucznej inteligencji. Nie jest publikacja teoretyczna ani akademickim przeglądem pojęć. Napisana jest przez praktyków dla praktyków - osób, które pracują z danymi, budują rozwiązania Data & AI, mierzą się z ograniczeniami projektowymi i szukają wiedzy osadzonej w konkretnym kontekście biznesowym.
Dużą wartością tej publikacji jest jej przemyślana struktura. Książka została podzielona na różne perspektywy, dzięki czemu czytelnik otrzymuje wielowymiarowy obraz pracy z danymi. Znajdziemy tu teksty eksperckie dotyczące kultury danych, budowania zespołów, odpowiedzialności, dojrzałości organizacyjnej i roli danych w podejmowaniu decyzji. Obok nich pojawiają się konkretne studia przypadków pokazujące rzeczywiste wdrożenia, wraz z ich kontekstem, wyzwaniami, ograniczeniami i rezultatami. Ważną częścią książki są także wywiady z praktykami, które nadają publikacji bardziej osobisty i bezpośredni charakter.
To, co szczególnie doceniam, to bliskość autorów wobec czytelnika. Nie tworzą dystansu między „ekspertem” a odbiorcą. Autorzy piszą z perspektywy osób, które przepracowały opisywane problemy. Dzięki temu książka jest wiarygodna, konkretna i użyteczna. Czuć w niej doświadczenie ludzi, którzy wiedzą, że projekty Data & AI nie dzieją się w idealnych warunkach - wymagają kompromisów, współpracy, odpowiedzialności i mierzenia się z niepewnością.
„Big Book of Real-World Use Cases in Data AI” można czytać na wiele sposobów: od początku do końca, wybiórczo, wracając do wybranych rozdziałów w zależności od aktualnych potrzeb projektowych. To książka, która sprawdza się nie tylko jako inspiracja, ale także jako praktyczny punkt odniesienia w pracy z danymi.
Zdecydowanie polecam ją osobom związanym z Data & AI, liderom zespołów, analitykom, konsultantom, menedżerom oraz wszystkim, którzy chcą lepiej zrozumieć, jak wygląda budowanie wartości z danych w organizacjach.
Beata Buryn
Dyrektor Biura Zarządzania Danymi, PEKAO
„Autorzy koncentrują się na konkretnych wdrożeniach, pokazując, jak inicjatywy Data & AI funkcjonują w realnym środowisku organizacyjnym, a nie jedynie w modelach teoretycznych.”
Czytaj całą recenzję
Książka „Big Book of Real World Use Cases in Data & AI” wydawnictwa Sofixit stanowi praktyczny i wartościowy przegląd rzeczywistych projektów realizowanych w obszarze zarządzania danymi oraz sztucznej inteligencji. Autorzy koncentrują się na konkretnych wdrożeniach, pokazując, jak inicjatywy Data & AI funkcjonują w realnym środowisku organizacyjnym, a nie jedynie w modelach teoretycznych.
Publikacja została podzielona na trzy główne części: eksperckie opowieści liderów transformacji danych (m.in. CDO, CTO, Head of IT & Data, CFO), opisy realnych use case’ów wykorzystania AI wraz z omówieniem warunków osiągnięcia korzyści biznesowych oraz wywiady z ekspertami. Opisane wdrożenia pochodzą z różnych branż i kontekstów - od farmacji i telekomunikacji, przez optymalizację sieci micromobilności, świat badań naukowych, aż po projekty o wymiarze społecznym, takie jak przeciwdziałanie niedożywieniu dzieci w Afryce. Ta różnorodność dobrze pokazuje uniwersalność wyzwań, przed którymi stoją organizacje pracujące z danymi.
Szczególną wartością książki jest nacisk na biznesowy i transformacyjny charakter projektów Data & AI. Autorzy podkreślają, że budowa organizacji data driven to proces wieloletni, oparty na zmianie kultury organizacyjnej, odpowiedzialności i współpracy z biznesem - a nie na samej technologii. Projekty AI przedstawione są jako przedsięwzięcia typu R&D, wymagające podejścia iteracyjnego, weryfikacji założeń poprzez PoC oraz gotowości do powrotu do pierwotnych hipotez w oparciu o feedback.
Dużo uwagi poświęcono data governance i jakości danych jako fundamentom wszelkich inicjatyw analitycznych i AI. Książka jasno pokazuje, że demokratyzacja danych bez kontroli prowadzi do chaosu, a governance nie ogranicza pracy zespołów, lecz usuwa niepewność i „zgadywanie”. Autorzy podkreślają również, że dojrzałość w obszarze jakości danych nie oznacza perfekcji, lecz świadome decyzje, kontrolę i odpowiedzialność osadzoną w procesach, które dane tworzą.
Publikacja nie idealizuje wdrożeń AI - zamiast tego pokazuje najczęstsze błędy, takie jak zaczynanie od technologii zamiast od danych i procesów czy automatyzowanie nieefektywnych procesów. Dzięki temu książka może pełnić rolę praktycznego przewodnika dla osób planujących i realizujących inicjatywy Data & AI.
Podsumowując, „Big Book of Real World Use Cases in Data & AI” to wartościowa pozycja dla CTO, CDO, liderów technicznych i biznesowych, architektów, inżynierów oraz product managerów. Książka dostarcza nie tylko inspiracji, ale przede wszystkim wiedzy opartej na doświadczeniach - pomocnej w budowaniu dojrzałych, mierzalnych i realnie wspierających biznes rozwiązań opartych na danych i sztucznej inteligencji.
Fragmenty
Trzy początki rozdziałów, tak jak w książce.
Część II: Case studies
Od pytania otwartego do insightu: AI w analizie jakościowej In-Pulse
In-Pulse to pierwszy w Polsce system narzędzi i produktów marketingowych typu Shopper-Led, obejmujący business consulting, badania i analitykę, testowanie konceptów, komunikacji marketingowej i produktów oraz retail media.
System In-Pulse opiera się na realnych danych pochodzących z ponad 12 000 sklepów Żabki, które codziennie generują około 4,2 mln transakcji (dane na grudzień 2025). Dane, połączone z zaawansowaną analityką opartą na sztucznej inteligencji, tworzą zintegrowany system pozwalający planować, testować i optymalizować działania marketingowe.
Czytaj fragment
Główny cel projektu
Celem projektu było zapewnienie wysokiej jakości informacji zbieranych w ramach badań oraz usprawnienie wewnętrznych procesów związanych z klasyfikacją pytań otwartych i odpowiedzi respondentów. Jest odpowiedzią również na coraz bardziej widoczne trendy w branży badawczej mówiące o tym, że nawet 69% respondentów nie jest ludźmi.
Przed wdrożeniem rozwiązania kodowanie otwartych wypowiedzi wymagało od zespołu nawet dwóch dni pracy przy prostych projektach badawczych. Dzięki automatyzacji i wykorzystaniu Gen AI czas ten został skrócony do kilku minut w przypadku pojedynczego projektu.
Naszym celem nie było całkowite wyeliminowanie człowieka z procesu, a raczej zapewnienie modelu hybrydowego, w którym człowiek aktywnie uczestniczy w uczeniu, walidacji i interpretacji wyników generowanych przez algorytmy. Za takim podejściem przemawiają przede wszystkim:
- Kontrola sensu i znaczenia - mniej „technicznie poprawnych”, a więcej merytorycznie trafnych kodów.
- Redukcja biasu algorytmicznego - bardziej trafna i zbalansowana analiza jakościowa.
- Dynamiczne doprecyzowanie schematu kodowania - schemat, który ewoluuje razem z danymi, a nie je upraszcza.
- Lepsze przełożenie wyników na decyzje biznesowe.
Element innowacyjności
Autorskie podejście wykorzystujące AI do oceny jakości odpowiedzi (PulseCheck) oraz klasyfikacji pytań otwartych (OpenPulse) wyróżnia kilka elementów, które wcześniej nie były łatwe do osiągnięcia:
- semantyczne rozumienie odpowiedzi otwartych, a nie tylko analiza słów kluczowych
- dynamiczne tworzenie kategorii - model sam proponuje strukturę kodów na podstawie danych, które nie były przewidziane w scenariuszu
- auto-uczący się system kodowania (active learning) - coraz lepsze kodowanie, trafniejsza ocena jakości i szybsze wyłapywanie nowych tematów
- wielopoziomowa klasyfikacja - tematyczna, emocjonalna, intencyjna
- ocena merytoryczna odpowiedzi - czy odnosi się do pytania, czy zawiera konkret, czy odpowiada na właściwy aspekt
- wykrywanie odpowiedzi niskiej jakości, wzorców „zawodowych respondentów” i odpowiedzi losowych lub generowanych automatycznie
- spójność odpowiedzi - porównanie odpowiedzi otwartych z zamkniętymi w ramach tej samej ankiety
- streszczenia wniosków jakościowych - „voice of customer” w postaci zagregowanych insightów
- wielojęzyczność i standaryzacja badań międzynarodowych - automatyczna normalizacja kategorii między językami i raporty w różnych językach przy spójnej strukturze.
To wstęp. Pełny opis wdrożenia In-Pulse - architektura, wyzwania techniczne i wyniki biznesowe - zajmuje w książce kolejne 11 stron.
Część I: Eksperckie opowieści
Pierwsze 100 dni Head of Data: trzy osie, które definiują sukces
Pierwsze 100 dni to moment prawdy dla każdego lidera Data & Analytics. To wtedy budujesz swoją wiarygodność w oczach zarządu, wyznaczasz rolę zespołu w organizacji i pokazujesz, czy Data będzie tylko funkcją wsparcia, czy strategicznym partnerem wzrostu.
Z mojego doświadczenia wynika, że sukces w tym okresie zależy od umiejętnego balansowania pomiędzy trzema osiami: operacyjną, strategiczną i zespołową.
Czytaj fragment
Oś operacyjna - „tu i teraz”
Każdy, kto obejmuje rolę Head of Data, ma naturalną pokusę, by od razu zabrać się za duże transformacje i ambitne projekty. Ale prawda jest taka, że na początku najważniejsza jest operacyjność.
Lubię porównywać dane do krwiobiegu organizacji. Możesz planować maraton (strategię), możesz trenować mięśnie (budować zespoły), ale jeśli krew nie krąży - ciało nie działa. Tak samo w firmie: raporty muszą się odświeżać, potoki muszą działać, a dane muszą być wiarygodne.
Dlatego mam jedną zasadę na pierwszy dzień: On Day 1 I focus on protecting what’s already working. To najszybszy sposób, aby zrozumieć biznes i jednocześnie nie zaszkodzić temu, co działa. Jeżeli coś generuje wyniki, Twoim zadaniem nie jest to „ulepszać”, tylko zidentyfikować i nie zepsuć. Dopiero potem można szukać sposobów, by usunąć tarcia i sprawić, że będzie działało jeszcze lepiej.
Dalej w rozdziale: oś strategiczna i oś zespołowa oraz plan na pierwsze 100 dni.
Część I: Eksperckie opowieści
Compose Your Next Reach: jak Autopay zmienił targetowanie reklam dzięki AI
W świecie, gdzie marketerzy dysponują większą ilością danych niż kiedykolwiek wcześniej, paradoksalnie czują się bardziej zagubieni. Autopay, polski lider w branży płatności cyfrowych, stanął przed wyzwaniem przekształcenia tego oceanu informacji w rzeczywistą wartość biznesową. Odpowiedzią był Composer - narzędzie oparte na danych i wykorzystujące sztuczną inteligencję.
Czytaj fragment
Paradoks obfitości danych
Autopay przetwarza rocznie ponad 160 milionów transakcji, gromadząc przy tym blisko 300 punktów danych dla każdego z ponad 6 mln użytkowników. Firma dysponuje szczegółowymi informacjami o zachowaniach konsumenckich, preferencjach płatniczych i wzorcach zakupowych. Jednak sama ilość danych stała się barierą - marketerzy nie byli w stanie wykorzystać tej wiedzy.
„Mieliśmy dostęp do niewiarygodnej ilości wartościowych informacji, ale przekładanie ich na konkretne decyzje marketingowe przypominało szukanie igły w stogu siana. Wiedzieliśmy, że musimy fundamentalnie zmienić podejście do wykorzystania tych danych” - Marcin Czeczot, Chief Commercial Officer Autopay Global.
Dalej w rozdziale: jak powstał Composer i co zmienił w kampaniach.
Dlaczego firma technologiczna wydaje książkę?
W Sofixit budujemy rozwiązania data i AI dla dużych organizacji w Polsce i Europie. Pracując z klientami, widzimy jedno: eksperci potrzebują wiedzy praktycznej, nie kolejnych kursów teoretycznych.
Kiedy zaczęliśmy rozmawiać z najlepszymi specjalistami z branży, okazało się, że wszyscy mają podobne spostrzeżenie - brakuje miejsca, w którym dzieli się prawdziwymi case studies. Nie sukcesami z prezentacji, ale rzeczywistymi decyzjami, błędami i wnioskami.
„Nie jesteśmy wydawnictwem, ale wiemy, jak wygląda praca z danymi w praktyce. Dlatego zdecydowaliśmy się stworzyć to, czego sami szukaliśmy - kompendium wiedzy od ludzi, którzy naprawdę rozwiązują problemy w swoich organizacjach.”
Nakład wyczerpany
Dodruk i e-book: lista oczekujących
Pierwszy nakład drukowany rozszedł się w całości. Zostawcie adres, a napiszemy, gdy ruszy dodruk albo pojawi się wersja elektroniczna. Nic poza tym - żadnego newslettera.
Zamówienia zbiorowe dla zespołów i firm przy dodruku: [email protected].
Pytania, które zadają kupujący
Czy książkę można jeszcze kupić?
Pierwszy nakład drukowany się wyczerpał. Zapiszcie się na listę oczekujących - powiadomimy o dodruku i o wersji e-book, gdy tylko będą dostępne.
Czy będzie wersja e-book?
Pracujemy nad nią, ale nie podajemy jeszcze terminu. Osoby z listy oczekujących dowiedzą się pierwsze.
W jakim języku jest książka?
W całości po polsku.
Co dokładnie zawiera?
Ponad 400 stron, 31 rozdziałów w trzech częściach: eksperckie opowieści, case studies rzeczywistych wdrożeń i wywiady z ekspertami. Każdy rozdział jest samodzielną całością.
Czy przy dodruku można zamówić egzemplarze dla zespołu albo firmy?
Tak. Napiszcie na [email protected] - ustalimy liczbę egzemplarzy i fakturę VAT.
Gdzie obejrzeć konferencję BIG BOOK LIVE?
Nagranie konferencji z 25 września 2026 jest bezpłatne. Po krótkiej rejestracji na stronie BIG BOOK LIVE wysyłamy link mejlem. Tam są też agenda i prelegenci.
Kto wydał książkę?
Sofixit sp. z o.o. z Wrocławia. Premiera: 18 marca 2026.
BIG BOOK LIVE · 25 września 2026
Konferencja, która wyrosła z książki
Cztery panele dyskusyjne autorów i recenzentów: o danych i AI od praktyków dla praktyków, o europejskiej infrastrukturze, o długu technologicznym i o błędach we wdrożeniach AI. Nagranie trwa ponad cztery godziny i jest bezpłatne, po krótkiej rejestracji.
Obejrzyj nagranie